№ 122026.11.15Ensaio8 minTambém em inglês
Um laboratório de LLM corporativo na sala de casa
Gateway único, chave com teto por projeto, aliases por capacidade, fallback entre provedores e um roteador que escolhe o modelo pela pergunta. Montei tudo isso no meu computador de casa para errar barato antes de propor na empresa, e o agente deste site roda em cima.
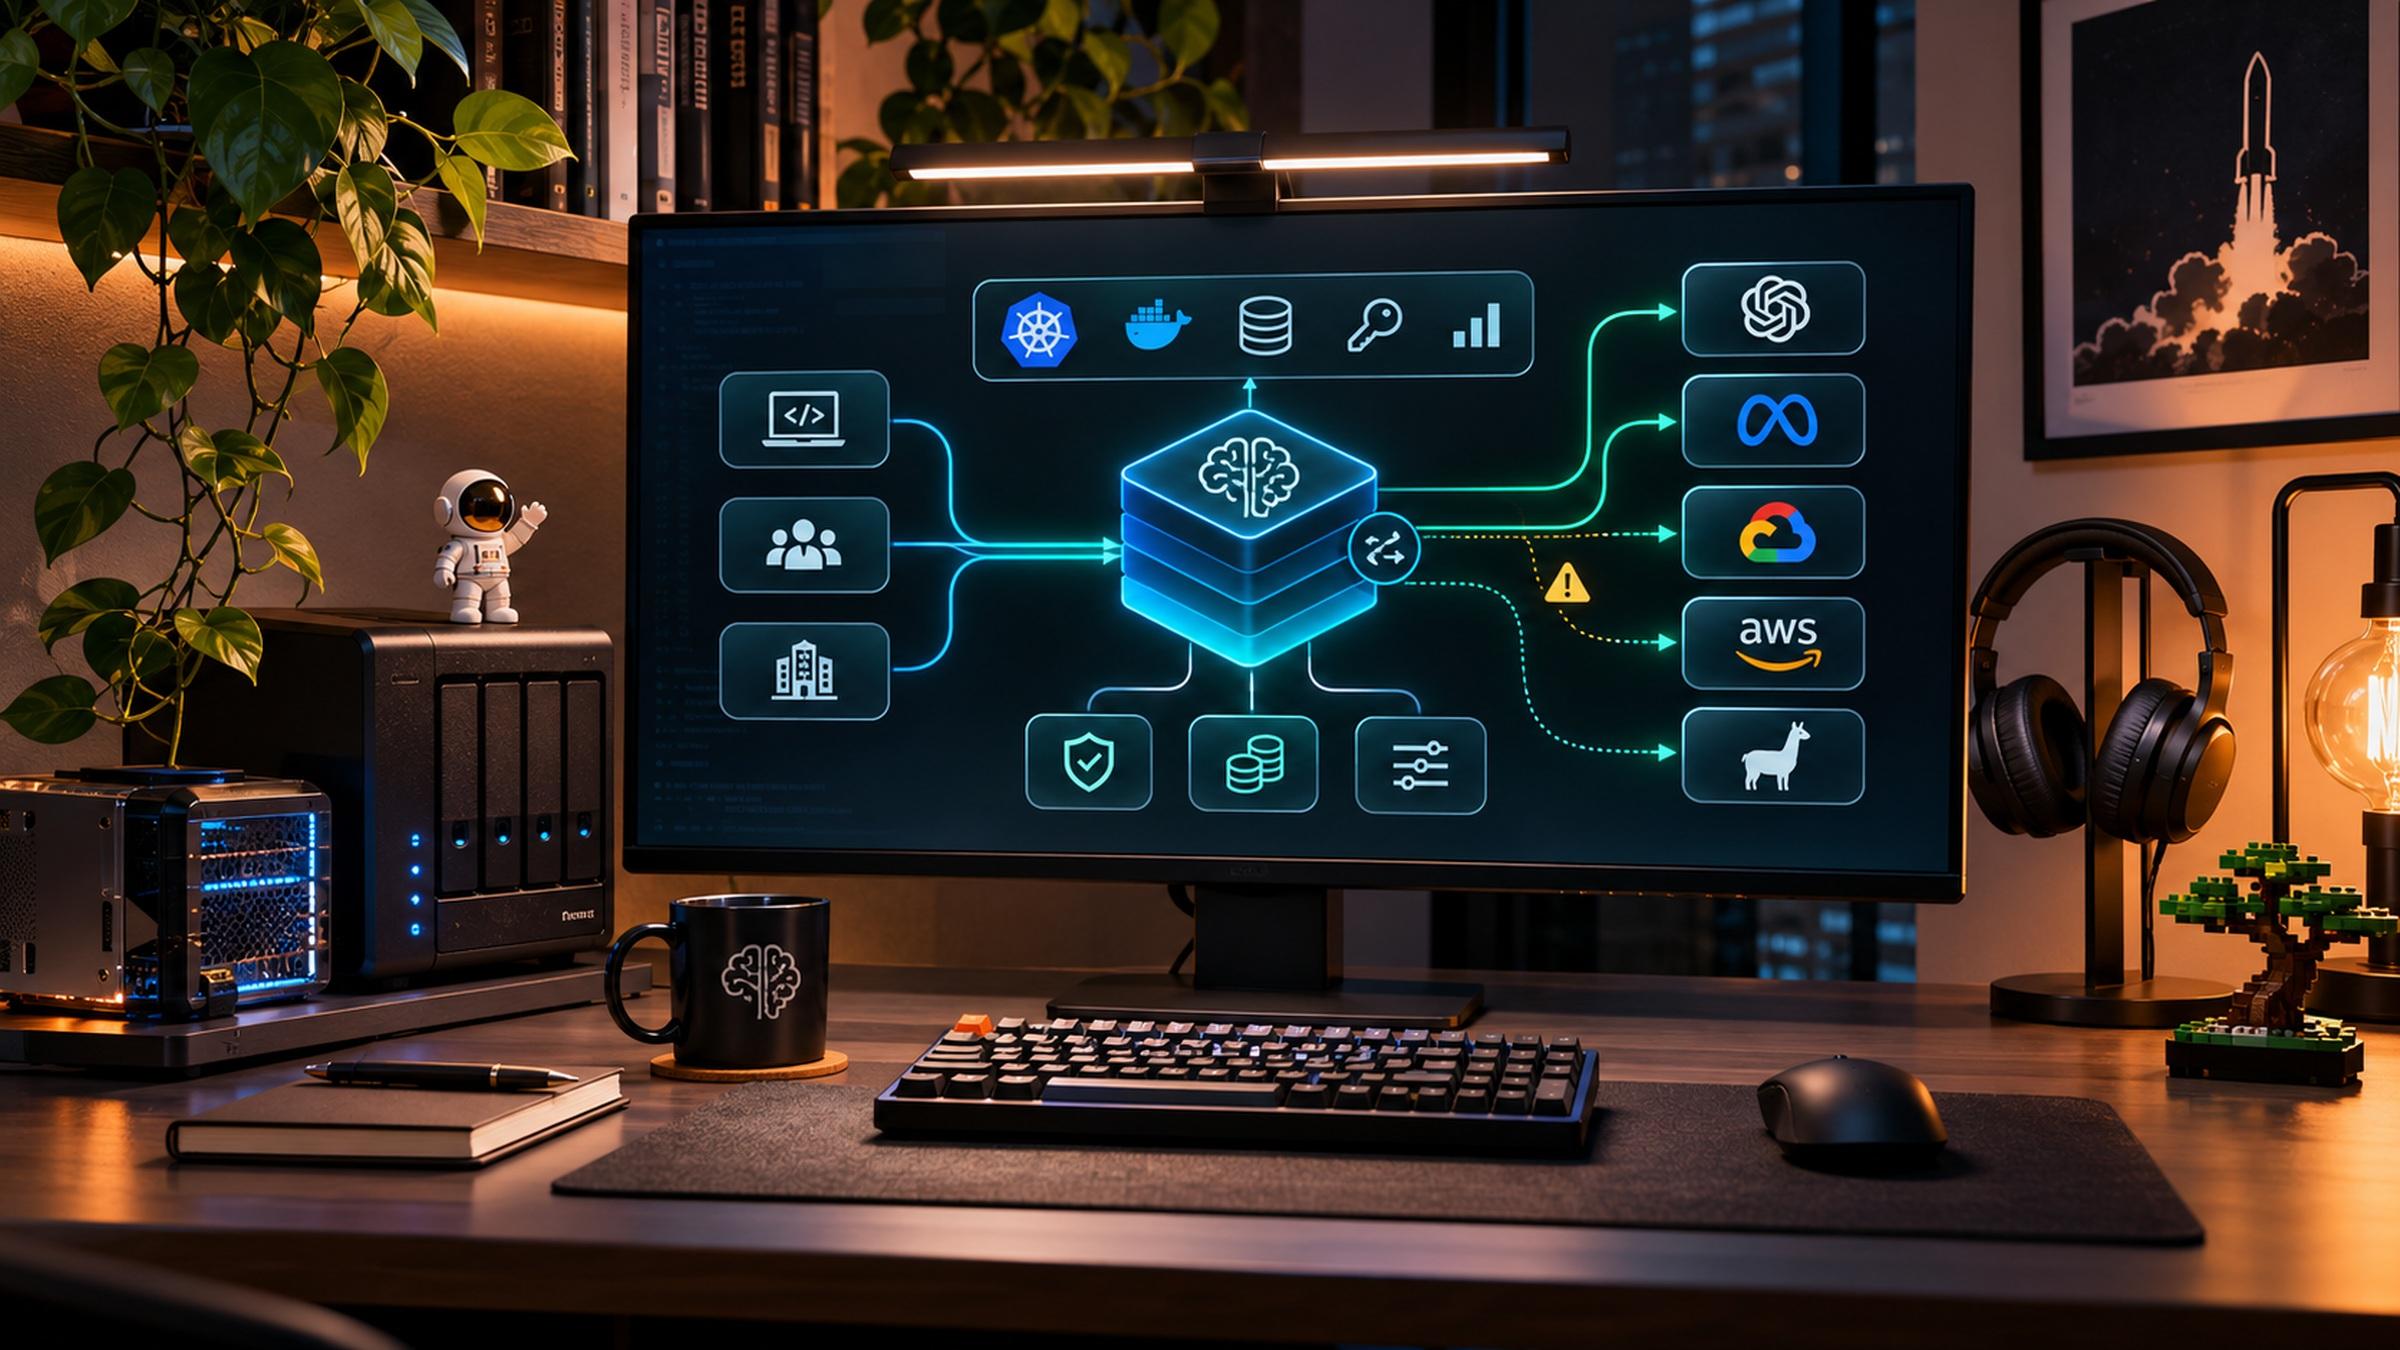
Quem desenha arquitetura de LLM numa empresa quase nunca tem onde errar barato. O gateway já está em produção, cada chave tem um dono, cada modelo novo passa por compras, e testar o que acontece quando um provedor cai significa derrubar alguma coisa que alguém está usando.
Então eu montei a mesma arquitetura em casa. Um computador com WSL2, um Kubernetes de bolso e as chaves de API de sempre, cobradas por uso. Nele eu quebro as coisas de propósito, meço o efeito e só depois levo a ideia para a mesa.
Este post conta as peças, como eu valido cada uma e como o agente "Pergunte sobre mim" da home deste site roda em cima delas. O caminho completo de uma pergunta do agente está na página Como funciona.
As peças
O desenho é o mesmo que eu defendo em empresa: os apps não falam com provedor nenhum, falam com um gateway.
- Kubernetes: um cluster k3d (k3s dentro do Docker) no WSL2. Cada coisa tem seu namespace; o gateway mora no
llm. - Gateway: LiteLLM com Postgres, compatível com a API da OpenAI. Qualquer app dentro do cluster aponta o SDK para
http://litellm.llm.svc.cluster.local:4000e pronto. - Publicação: um conector do Cloudflare Tunnel rodando dentro do cluster. Ele abre o túnel de dentro para fora, então não existe porta aberta no meu roteador.
Aliases por capacidade, não por modelo
Os projetos não pedem um modelo pelo nome. Pedem uma capacidade:
| Alias | Hoje aponta para | Uso |
|---|---|---|
smart |
Claude Opus | raciocínio pesado |
fast |
Claude Haiku | resposta rápida e barata |
cheap |
Gemini Flash | volume |
embed |
embeddings da OpenAI (1536 dimensões) | busca semântica |
auto |
o Jev escolhe (mais abaixo) | quando você não quer escolher |
Trocar o modelo atrás de um alias é editar uma linha de configuração do gateway. Nenhum app muda. Para quem precisa de um modelo específico, existe passthrough por provedor (anthropic/*, openai/*, gemini/*), que resolve 308 modelos.
Fallback entre provedores
Cada alias tem um plano B, e o plano B é de propósito em outro provedor: smart cai para fast, fast cai para cheap, cheap volta para fast. Se a Anthropic sair do ar, fast passa a ser atendido pelo Gemini.
Isso eu não aceitei pela configuração. Quebrei a chave da Anthropic de propósito e chamei smart: quem respondeu foi o Gemini Flash.
Uma chave por projeto, com teto
Cada projeto recebe a própria chave virtual, com os aliases que pode usar, um orçamento e uma janela:
curl -s http://litellm.localhost/key/generate \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" -H 'Content-Type: application/json' \
  -d '{"key_alias":"meu-projeto","models":["fast","cheap"],"max_budget":5,"budget_duration":"30d"}'
Quando o teto estoura, o gateway responde 429 com type: budget_exceeded e recusa a chamada. Não é só um alerta. Um loop acidental queima o teto daquele projeto e para; a conta inteira fica de pé. Esse detalhe do 429 eu descobri testando, porque a documentação não diz.
Jev: o alias que escolhe o modelo
O auto não é um modelo. É um hook do LiteLLM que, antes do roteamento, pergunta ao Jev, da TypeSafe, se aquele prompt pede fast, smart ou cheap, e reescreve o campo model com a resposta. Depois disso tudo segue nativo: fallback, orçamento e gasto são contabilizados no alias escolhido.
As regras que eu coloquei em volta:
- Se o Jev der erro, passar de 2 segundos ou responder com confiança abaixo de 0,5, o pedido vai para
fast. O roteador nunca é o motivo de uma chamada falhar. - O custo é de 200 a 300 milissegundos a mais por chamada em
auto. Os outros aliases não passam pelo Jev. - Para saber quem atendeu, a resposta traz o header
X-Litellm-Model-Group, e o log de gasto ganha as tagsauto:<alias>eauto-why:<motivo>.
Teve uma pegadinha que só apareceu testando. O LiteLLM confere a permissão da chave antes do hook rodar, e nessa hora ele só vê auto. Sem cuidado, uma chave com auto poderia acabar no Opus mesmo sem ter permissão para smart. A correção foi fazer o hook escolher só entre os destinos que a chave já pode usar: uma chave com ["auto", "fast", "cheap"] nunca chega ao Opus, e uma chave com só auto leva 403.
E tem um ponto que vale para qualquer roteador terceirizado: todo prompt em auto também vai para a TypeSafe, para ser classificado. Para um laboratório isso é aceitável. Para o agente público deste site, não, e por isso a chave do site não tem auto.
Playground e validação
Eu separo as duas coisas.
Playground é para explorar: a UI de admin do LiteLLM, para criar chave e disparar uma chamada à mão, e curl para tudo que eu quero repetir. É onde eu descubro como um modelo se comporta antes de virar alias.
Validação é provar pelo efeito, não pela linha de configuração. Valor errado em config costuma ser aceito em silêncio, então cada regra ganha um teste que só passa se a regra estiver valendo de verdade:
- Matriz de permissão: para cada chave, chamo cada alias e confiro o código. A chave do site, por exemplo:
fast200,smart403,cheap403. - Provedor fora: quebro a chave de um provedor e vejo o fallback atender pelo outro.
- Teto: dou um orçamento minúsculo a uma chave de teste e confirmo o 429.
- Roteador fora: com o Jev sem resposta, o
autotem que cair emfast.
E foi testando que apareceram as pegadinhas que nenhuma documentação me contou:
max_tokensbaixo com modelo de raciocínio devolve resposta vazia. Opus e Gemini Flash gastam o limite inteiro pensando e voltamcontent: null. O Haiku, que não raciocina, responde normalmente com o mesmo limite. Não é defeito de roteamento.- O campo
modelda resposta ecoa o alias, não o modelo concreto. Para saber quem atendeu, olhe as impressões digitais: camposvertex_ai_*indicam Gemini, assinatura de raciocínio estendido indica Anthropic. /key/infomente sobre o gasto. Ele devolveuspend: 0.0para uma chave com o orçamento estourado. Para ler gasto, uso/key/listcom o objeto completo.- Apagar o pod do gateway parece URL errada. Com uma réplica e 120 segundos de espera para ficar pronto, o Service fica sem destino e o Traefik responde 404, não 503, por uns 2 minutos.
rollout restartnão tem essa queda, porque o pod antigo atende até o novo ficar pronto.
O caso real: o agente deste site
O campo "Pergunte sobre mim" da home é o primeiro consumidor público do laboratório. A Vercel chama llm.kauecode.com, que fica atrás de um Cloudflare Access: sem o service token, a borda responde 403 e nada chega na minha casa. Do lado do gateway, o site usa uma chave só dele, presa ao alias fast, com US$ 5 a cada 30 dias.
Quando o computador desliga, o agente aparece offline em até um minuto e volta sozinho. Eu escolhi não ter fallback para uma API paga: se a plataforma de casa está fora, o agente está fora.
A primeira versão já ensinou coisa. A terceira pergunta de qualquer conversa falhava, porque cada pergunta leva uns 9 mil tokens de contexto e a chave tinha limite de 20 mil tokens por minuto. E o modelo inventou um hobby meu, coisa que um agente em primeira pessoa não pode fazer. Os detalhes, as decisões e o código de cada passo estão na página Como funciona.
Da sala de casa para a empresa
Nada aqui é brinquedo. Cada peça tem par direto num ambiente corporativo, e é isso que torna o laboratório útil:
| Na minha casa | Na empresa |
|---|---|
| k3d no WSL2 | EKS, AKS ou GKE |
| LiteLLM com Postgres | o gateway corporativo de LLM |
| chave virtual por projeto, com teto | chave por time ou produto, com orçamento e dono |
| aliases por capacidade | catálogo de modelos aprovados |
| fallback entre provedores | continuidade quando um fornecedor cai |
Jev no alias auto |
roteamento por custo e complexidade |
| Cloudflare Access com service token | zero trust entre serviços |
| log de gasto com tags | FinOps de IA: quem gastou, com o quê, por quê |
O valor não está em copiar a pilha. Está em chegar na reunião já sabendo onde ela quebra: que o 429 de orçamento é recusa e não alerta, que o roteador precisa respeitar a permissão da chave, que todo roteador terceirizado vê o prompt, que o campo model da resposta não diz quem atendeu.
O que ainda falta
O alias local, com um modelo rodando na minha GPU, ainda não existe. A placa é uma GTX 1660 Ti, e hoje ela não funciona dentro de container: falta o nvidia-container-toolkit. A decisão de onde esse motor vai rodar ficou para depois.
E tem uma lição de operação que eu anotei com letra grande: a chave que criptografa as credenciais no banco do LiteLLM não pode ser trocada depois que os modelos estão cadastrados. Backup do banco sem essa chave não restaura nada. Os dois andam juntos, fora da máquina.
Para montar o seu
- Suba um Kubernetes local (k3d, kind ou o do Docker Desktop).
- Instale o LiteLLM com Postgres e cadastre dois provedores diferentes.
- Crie aliases por capacidade e configure o fallback cruzando provedores.
- Dê uma chave com teto para cada projeto, inclusive os seus experimentos.
- Quebre de propósito: provedor fora, orçamento estourado, roteador fora. Anote o que acontece de verdade.
- Se for publicar alguma coisa, publique atrás de autenticação na borda, nunca com a porta aberta.
O resto você descobre quebrando.